Definition: Was ist Canonical Tag??
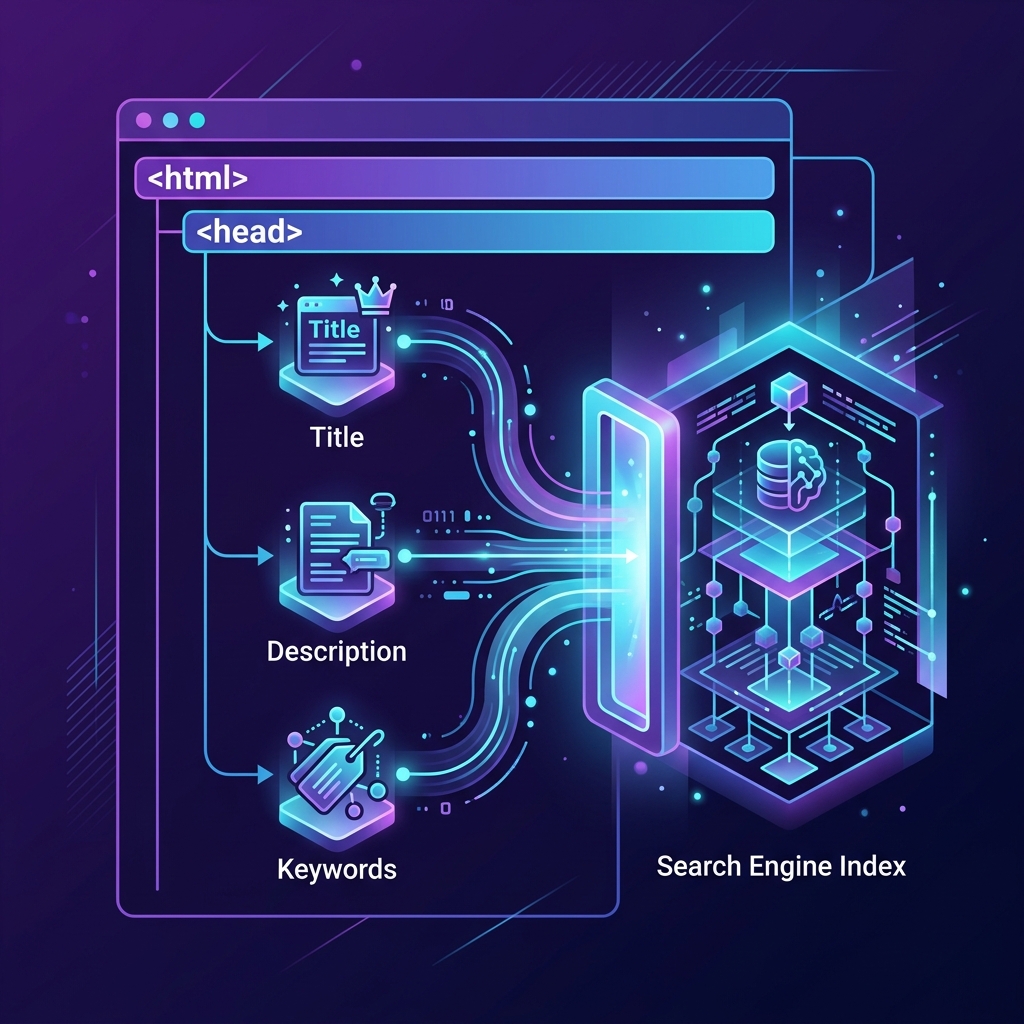
Das Canonical Tag ist eine erweiterte HTML-Meta-Anweisung, die verwendet wird, um die Master- oder Primärversion eines Webdokuments in einer Gruppe identischer Dokumente explizit zu deklarieren, nahezu identisch, oder strukturell duplizierte URLs.
In komplexen Web-Architekturen – etwa der facettenreichen E-Commerce-Navigation, Verfolgung der Parameterausbreitung, oder dynamische Sitzungs-ID-Generierung – auf einen einzelnen eindeutigen Inhalt kann theoretisch über unendlich viele Permutationen einer URL-Zeichenfolge zugegriffen werden. Das Canonical-Tag fungiert als ultimativer programmatischer Schiedsrichter, Anweisung an Suchmaschinen-Crawler, die Indexierung zu konsolidieren, Link-Equity zusammenführen, und alle Relevanzsignale der einzelnen deklarierten kanonischen URL zuordnen, Dadurch wird die katastrophale Verwässerung der Domain-Autorität verhindert, die als „Keyword-Kannibalisierung“ bekannt ist..
Entscheidend, Der Canonical-Tag wird von Google als definiert “starker Hinweis” eher als eine absolute Richtlinie. Wenn die maschinellen Lernmodelle einer Suchmaschine eine schwerwiegende Diskrepanz zwischen der kanonischen Deklaration und dem tatsächlichen Content-Clustering auf der Website feststellen, Der Algorithmus verfügt über die Autonomie, das kanonische Tag des Webmasters aggressiv zu überschreiben und algorithmisch eine andere kanonische Version auszuwählen. daher, Eine einwandfreie Umsetzung erfordert architektonische Konsistenz.
1. Historische Entwicklung & Branchenhintergrund
Das Canonical-Tag entstand aus purer technischer Notwendigkeit. Vor Februar 2009, Suchmaschinen befanden sich in einer existenziellen Krise hinsichtlich Indexaufblähung und Rechenleistung. Die Explosion dynamischer CMS-Plattformen führte dazu, dass ein einziges Paar Schuhe Hunderte von URLs basierend auf Sortierparametern generieren konnte (z.B.,?sort=price_asc, ?color=red, ?size=10). Suchmaschinen wurden zum Crawlen gezwungen, Verfahren, Index, und ordnen Sie alle diese identischen Seiten einzeln. Dadurch wurden nicht nur Milliarden von Dollar an Rechenleistung verschwendet, aber es zerstörte auch die Rankings der Webmaster, da eingehende Links über fünfzig verschiedene URL-Variationen verstreut waren.
In einem historischen, beispiellose Zusammenarbeit, die drei größten Suchmaschinenkonkurrenten (Google, Yahoo, und Microsoft) gemeinsam angekündigte Unterstützung für dierel="canonical" Linkelement. Dieser einheitliche Standard ermöglichte es Entwicklern, eine einfache Codezeile in den HTTP-Header oder HTML-Header einzufügen, um die Duplicate-Content-Krise zu lösen, ohne dass komplexe Anforderungen erforderlich sind, serverlastige Umleitungsregeln.
Als sich das Web weiterentwickelte, die Komplexität der Kanonisierung nahm zu. Der Aufstieg der Mobile-First-Indexierung erforderte kanonische Beziehungen zwischen Desktop- und Mobildomänen. Die explosionsartige Verbreitung internationaler Suchmaschinenoptimierung erforderte komplexe Wechselwirkungen zwischen ihnenhreflang Tags und kanonische Tags. Heute, Kanonisierung ist kein einfaches Schlagwort; es ist kompliziert, Programmgesteuerter Signalgraph, der die gesamte Crawling-Effizienz und Indexierungsstruktur von Domänen auf Unternehmensebene bestimmt.
2. Kernmechanismen & Prinzipien
Die Mechanismen, mit denen Suchmaschinen kanonische Tags verarbeiten, sind äußerst komplex, mit mehreren Parsing-Stufen, Signalaggregation, und Konfliktlösung.
2.1 Die Konsolidierung von Link Equity (PageRank-Übertragung)
Wenn der Googlebot crawltURL_A und entdeckt ein kanonisches Tag, das darauf verweistURL_B, Es initiiert eine PageRank-Konsolidierungsroutine. Der Algorithmus von Google behandelt effektivURL_A als Alias vonURL_B. Alle externen Backlinks, die darauf verweisenURL_A (Zum Beispiel, ein Link von einem Blogger, der versehentlich auf eine URL verlinkt hat, die a enthält?utm_source=twitter Tracking-Parameter) werden mathematisch umgeleitet. Der PageRank-Wert wird an übertragenURL_B, Genau so, als ob der Blogger direkt auf die saubere URL verlinkt hätte. Dadurch wird sichergestellt, dass keine externe Autorität verschwendet wird.
2.2 Crawl-Budget-Optimierungsprotokoll
In einer Unternehmensumgebung mit 10 Millionen facettierte URLs, Der Googlebot kann nicht alles crawlen. Der kanonische Mechanismus hilft dem Algorithmus, URL-Muster zu lernen. Im Laufe der Zeit, Googlebot erfährt, dass URLs enthalten?sort= kanonisieren Sie immer auf die Basiskategorieseite. Folglich, Der Crawler passt seine Crawl-Planungsalgorithmen dynamisch an, um die Anforderung der parametrisierten URLs vollständig einzustellen, enorme Mengen an sparen “Crawl-Budget” und Umleiten dieser Servertreffer, um neue zu entdecken, neue Inhalte.
2.3 Algorithmische Überschreibungen und das „Gefaltete“.’ Index
Google behauptet ein „gefaltet“.’ Index, in dem duplizierte Dokumente gruppiert werden. Das Canonical-Tag ist eine Abstimmung darüber, welches Dokument der „Lead“ sein soll’ in dieser Falte. Jedoch, Google stellt Querverweise zwischen dem Canonical-Tag und anderen Signalen her: 301 Weiterleitungen, Einbindung einer XML-Sitemap, HTTPS-Status, interne Verlinkungsstruktur, und Inhalts-Hashes. Wenn Ihr Canonical-Tag auf eine HTTP-Seite verweist, aber alle Ihre internen Links verweisen auf die HTTPS-Version, Die Signale sind widersprüchlich. Das Modell des maschinellen Lernens überschreibt Ihr Tag, es völlig ignorieren. Konsistenz über alle Signalisierungskanäle hinweg ist zwingend erforderlich.
3. Strategischer SEO-Wert & Tiefgreifende Wirkung
Die strategische SEO-Auswirkung einer fehlerfreien Kanonisierung ist immens, insbesondere für E-Commerce, Immobilie, und riesige redaktionelle Websites. Ohne es, Ein Standort wird langsam unter seinem eigenen Gewicht ersticken.
Schluss mit der Kannibalisierung von Schlüsselwörtern: Wenn mehrere identische Seiten vorhanden sind, Google hat Schwierigkeiten, herauszufinden, welches Ranking er einstuft. Es kann schnell zwischen URL-Varianten in den SERPs wechseln, Lassen Sie niemals zu, dass eine einzelne URL genügend historisches Vertrauen aufbaut, um die Position zu erreichen 1. Die Kanonisierung zwingt den Algorithmus zum Handeln, Konsolidierung aller Relevanzsignale auf einer einzigen Champion-URL, Dies führt zu explosiven Rangverbesserungen für konkurrenzfähige Spitzenpositionen.
Syndizierungsschutz: Große Verlage veröffentlichen ihre Inhalte oft an große Nachrichtennetzwerke. Wenn eine kleinere Website eine Originaluntersuchung veröffentlicht, und eine riesige Website syndiziert es, Aufgrund der reinen Domain-Autorität wird die riesige Website fast immer den ursprünglichen Ersteller übertreffen. Der einzige technische Schutz besteht darin, dass der Syndizierungspartner einen domänenübergreifenden kanonischen Tag bereitstellen muss, der auf die ursprüngliche Quell-URL verweist. Dadurch wird die enorme Domain-Autorität des Syndikators zurück auf den ursprünglichen Ersteller übertragen, Schutz ihres geistigen Eigentums.
4. Praktische Umsetzung & Best Practices für die Technik
Die Implementierung kanonischer Tags erfordert absolute programmatische Präzision. Ein einzelner Logikfehler im Header einer globalen Website kann versehentlich Millionen von Seiten deindizieren.
4.1 Absolute URLs sind obligatorisch
Verwenden Sie niemals relative URLs in einem kanonischen Tag. Relative URLs sind anfällig für Basispfadmanipulationen und Strukturfehler.
<!-- DANGEROUS / INCORRECT -->
<link rel="canonical" href="/mens-shoes/sneakers/" />

<!-- FLAWLESS / CORRECT -->
<link rel="canonical" href="https://[YOUR_DOMAIN]/mens-shoes/sneakers/" />
4.2 Kanonisierung von HTTP-Headern für Nicht-HTML-Assets
Ein massives technisches Versehen besteht darin, dass Nicht-HTML-Dateien nicht kanonisiert werden, wie zum Beispiel PDF-Dokumente. Wenn Sie eine Webseite haben, auf der eine Softwarefunktion erklärt wird, und eine herunterladbare PDF-Version genau desselben Handbuchs, Sie werden in den SERPs konkurrieren. Sie können kein HTML einfügen<link> Tag in einem PDF einfügen. Sie müssen Ihren Server konfigurieren (Apache/Nginx) um die kanonische Direktive innerhalb des HTTP-Antwortheaders zu senden.
# Nginx Configuration Example: Adding Canonical HTTP Header to PDFs
location ~* \.pdf$ {
    # Assuming the PDF filename matches the HTML page path
    add_header Link "<https://[YOUR_DOMAIN]$uri>; rel="canonical"";
}
Diese fortschrittliche Technik stellt sicher, dass alle direkt zur PDF-Datei erstellten Links nahtlos auf die primäre HTML-Landingpage übertragen werden, seine Ranking-Power radikal steigern.
4.3 Selbstreferenzierende Canonicals als Abwehrmechanismus
Jede einzelne Primärseite Ihrer Website muss über ein kanonisches Tag verfügen, das genau auf die eigene URL verweist (Selbstreferenzierung). Warum? Weil böswillige Schaber, Content-Diebe, und kaputte Proxyserver können Ihr HTML auslesen und es auf einer anderen Domain hosten. Wenn Ihr HTML einen hartcodierten Code enthält, absolutes kanonisches Tag, das auf Ihre authentische Domain verweist, Der Scraper teilt Google versehentlich mit, “Ich bin ein Duplikat; Geben Sie der ursprünglichen Website die gesamte Ranking-Power.” Es ist die ultimative automatisierte Verteidigung gegen Inhaltsdiebstahl.
4.4 Validierung der kanonischen Logik mit Python
In massiven Migrationen, Kanonische Logik kann scheitern. Unten finden Sie ein Enterprise-Python-Skript zum Parsen einer XML-Sitemap, Extrahieren Sie die URLs, krieche sie, und stellen Sie sicher, dass das Canonical-Tag genau mit der in der Sitemap aufgeführten URL übereinstimmt.
import requests
from bs4 import BeautifulSoup
import xml.etree.ElementTree as ET

def audit_sitemap_canonicals(sitemap_url):
    response = requests.get(sitemap_url)
    root = ET.fromstring(response.content)
    namespace = {'ns': 'http://www.sitemaps.org/schemas/sitemap/0.9'}
    urls = [elem.text for elem in root.findall('.//ns:loc', namespace)]

    errors = 0
    for url in urls[:10]: # Check a sample
        try:
            page = requests.get(url, timeout=5)
            soup = BeautifulSoup(page.text, 'html.parser')
            canonical_tag = soup.find('link', rel='canonical')

            if not canonical_tag:
                errors += 1
                continue

            canonical_href = canonical_tag.get('href')
            if canonical_href != url:
                errors += 1
        except Exception as e:
            pass

    print(f"Audit Complete. Found {errors} fatal canonical errors.")
5. Erweiterte technische Edge-Fälle & Häufige Missverständnisse
Schwerwiegender technischer Fehler: Kanonisierung paginierter Serien.
Einer der destruktivsten Fehler, die junge Entwickler machen, ist die Platzierung eines Canonical-Tags auf der Seite 2, Seite 3, und Seite 4 eines Kategoriearchivs, das auf eine Seite verweist 1 (/category?page=2 kanonisieren zu/category). Seite 2 enthält völlig andere Produkte als Page 1; es handelt sich nicht um Duplikate. Wenn Sie die Seite kanonisieren 2 zur Seite 1, Google wird die Seite komplett löschen 2 aus dem Index. Das bedeutet, dass der Suchcrawler niemals die Links zu den tief verschachtelten Produkten auf der Seite entdecken wird 2, effektiv entfernen 80% Ihres E-Commerce-Katalogs aus der Google-Datenbank. Paginierte Seiten müssen selbstreferenzierende Canonicals enthalten.
Missverständnis: “Ich kann Canonical Tags verwenden, um ein abgekündigtes Produkt auf meine Homepage weiterzuleiten.”
Die Realität: Dies ist ein schwerwiegender Missbrauch der Richtlinie. Ein Canonical-Tag darf nur für identische oder sehr ähnliche Inhalte verwendet werden. Eine bestimmte Produktseite hat semantisch nichts mit einer riesigen Homepage zu tun. Die Algorithmen von Google erkennen die extreme inhaltliche Diskrepanz und ignorieren das Canonical-Tag dauerhaft. Für abgekündigte Produkte, Sie müssen a verwenden 301 Serverweiterleitung zu einer hochrelevanten Unterkategorieseite, oder servieren Sie a 410 (Gegangen) Statuscode.
6. Zukünftige Trends im Zeitalter der generativen Suche
Während wir in eine Ära übergehen, die von KI-Agenten und großen Sprachmodellen dominiert wird, Das Canonical Tag wird sich von einem einfachen Deduplizierungstool zu einem weiterentwickelnHerkunfts-Provenienz-Anker. Generative Motoren synthetisieren Informationen aus Tausenden von Quellen, Die Verfolgung geistigen Eigentums wird von größter Bedeutung. Suchmaschinen werden LLMs, die Daten ohne ordnungsgemäße Zitierung halluzinieren, stark bestrafen. Das kanonische Tag, kombiniert mit neuen kryptografischen Inhaltssignaturen, dient als algorithmischer Eigentumsnachweis. Wenn eine KI eine Antwort generiert, Dadurch werden die semantischen Konzepte bis zur ursprünglichen kanonischen URL zurückverfolgt, Sicherstellen, dass der ursprüngliche Ersteller Zitationsnachweise und Empfehlungsverkehr erhält.
📚 Maßgebliche Referenzen
- https://Developers.google.com/search/docs/crawling-indexing/consolidate-duplicate-urls
- https://datatracker.ietf.org/doc/html/rfc6596
- https://ahrefs.com/blog/canonical-tags/
- https://nginx.org/en/docs/http/ngx_http_headers_module.html
Autor:Wanglitou,Bitte geben Sie bei der Weiterleitung die Quelle an: https://www.wanglitou.com/canonical-tag/