Definizione: Cos'è il tag canonico?
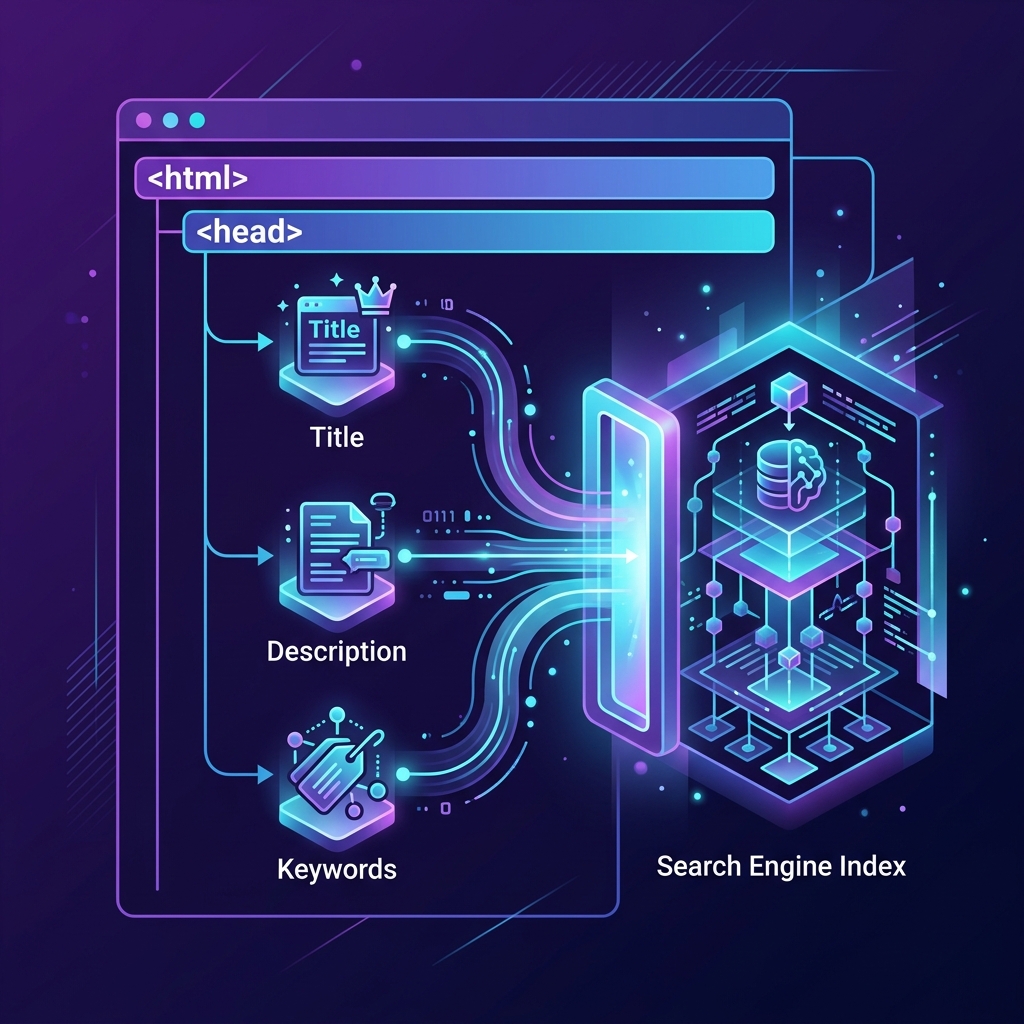
Il Canonical Tag è una meta direttiva HTML avanzata utilizzata per dichiarare esplicitamente la versione master o primaria di un documento web tra un cluster di documenti identici, quasi identico, o URL strutturalmente duplicati.
In architetture web complesse, come la navigazione e-commerce sfaccettata, monitoraggio della propagazione dei parametri, o generazione dinamica di ID di sessione: teoricamente è possibile accedere a un singolo contenuto univoco tramite infinite permutazioni di una stringa URL. Il tag canonico funge da arbitro programmatico finale, istruire i crawler dei motori di ricerca a consolidare l'indicizzazione, unire l'equità dei collegamenti, e attribuire tutti i segnali di pertinenza al singolo URL canonico dichiarato, prevenendo così la catastrofica diluizione dell’autorità di dominio nota come “cannibalizzazione delle parole chiave”.
Fondamentalmente, il tag canonico è definito da Google come a “suggerimento forte” piuttosto che una direttiva assoluta. Se i modelli di machine learning di un motore di ricerca rilevano una grave discrepanza tra la dichiarazione canonica e l’effettivo raggruppamento dei contenuti sul sito, l’algoritmo possiede l’autonomia per sovrascrivere in modo aggressivo il tag canonico del webmaster e selezionare algoritmicamente una versione canonica diversa. Perciò, un'implementazione impeccabile richiede coerenza architettonica.
1. Evoluzione storica & Contesto del settore
Il tag Canonical è nato per pura necessità ingegneristica. Prima di febbraio 2009, i motori di ricerca hanno dovuto affrontare una crisi esistenziale dovuta all'aumento dell'indice e alla potenza di elaborazione. L'esplosione delle piattaforme CMS dinamiche ha fatto sì che un singolo paio di scarpe potesse generare centinaia di URL in base a parametri di ordinamento (per esempio.,?sort=price_asc, ?color=red, ?size=10). I motori di ricerca sono stati costretti a eseguire la scansione, processo, indice, e classificare individualmente tutte queste pagine identiche. Ciò non solo ha sprecato miliardi di dollari in elettricità computazionale, ma ha anche distrutto il ranking dei webmaster, poiché i collegamenti in entrata erano sparsi in cinquanta diverse varianti di URL.
In uno storico, collaborazione senza precedenti, i tre principali concorrenti dei motori di ricerca (Google, Yahoo, eMicrosoft) annunciato congiuntamente il supporto per ilrel="canonical" elemento di collegamento. Questo standard unificato ha consentito agli sviluppatori di inserire una semplice riga di codice nell'intestazione HTTP o nell'intestazione HTML per risolvere la crisi dei contenuti duplicati senza richiedere complesse, regole di reindirizzamento pesanti per il server.
Come il web si è evoluto, la complessità della canonicalizzazione è aumentata. L’ascesa del Mobile-First Indexing ha richiesto relazioni canoniche tra i domini desktop e mobile. L'esplosione della SEO internazionale ha reso necessarie complesse interazioni trahreflang tag e tag canonici. Oggi, la canonicalizzazione non è un semplice tag; è una cosa complessa, grafico del segnale programmatico che determina l'intera efficienza della scansione e la struttura di indicizzazione dei domini di livello aziendale.
2. Meccanismi fondamentali & Principi
I meccanismi con cui i motori di ricerca elaborano i tag canonici sono molto complessi, coinvolgendo più fasi di analisi, aggregazione del segnale, e risoluzione dei conflitti.
2.1 Il consolidamento del capitale di collegamento (Trasferimento del PageRank)
Quando Googlebot esegue la scansioneURL_A e scopre un tag canonico che punta aURL_B, avvia una routine di consolidamento del PageRank. L’algoritmo di Google tratta efficacementeURL_A come alias diURL_B. Eventuali backlink esterni che puntano aURL_A (Per esempio, un collegamento da un blogger che si è collegato accidentalmente a un URL contenente un file?utm_source=twitter parametro di tracciamento) vengono matematicamente reindirizzati. Il valore PageRank viene trasferito aURL_B, esattamente come se il blogger si fosse collegato direttamente all'URL pulito. Ciò garantisce che nessuna autorità esterna venga sprecata.
2.2 Protocollo di ottimizzazione del budget di scansione
In un ambiente aziendale con 10 milioni di URL sfaccettati, Googlebot non può eseguire la scansione di tutto. Il meccanismo canonico aiuta l'algoritmo ad apprendere i modelli URL. Col tempo, Googlebot apprende che gli URL contenenti?sort= canonicalizzare sempre nella pagina della categoria base. Di conseguenza, il crawler regola dinamicamente i suoi algoritmi di pianificazione della scansione per interrompere completamente la richiesta degli URL con parametri, risparmiando enormi quantità di “Scansione del budget” e reindirizzare gli accessi al server alla scoperta di nuovi file, nuovi contenuti.
2.3 Override algoritmici e "Folded".’ Indice
Google mantiene un file "piegato".’ indice in cui vengono raggruppati i documenti duplicati. Il tag canonico è un voto per quale documento dovrebbe essere il "lead".’ in quella piega. Tuttavia, Google incrocia il tag canonico con altri segnali: 301 reindirizzamenti, Inclusione della mappa del sito XML, Stato HTTPS, struttura di collegamento interna, e hash dei contenuti. Se il tuo tag canonico punta a una pagina HTTP, ma tutti i tuoi collegamenti interni puntano alla versione HTTPS, i segnali sono contrastanti. Il modello di machine learning sovrascriverà il tuo tag, ignorandolo del tutto. La coerenza tra tutti i canali di segnalazione è obbligatoria.
3. Valore strategico SEO & Impatto profondo
L’impatto SEO strategico di una canonicalizzazione impeccabile è immenso, in particolare per l'e-commerce, immobiliare, e enormi siti editoriali. Senza di esso, un sito soffocherà lentamente sotto il suo stesso peso.
Sradicare la cannibalizzazione delle parole chiave: Quando esistono più pagine identiche, Google fatica a determinare quale classificare. Potrebbe passare rapidamente tra le varianti URL nelle SERP, non consentire mai a un singolo URL di accumulare sufficiente fiducia storica per raggiungere la posizione 1. La canonicalizzazione forza la mano dell’algoritmo, consolidando tutti i segnali di pertinenza in un unico URL campione, con conseguenti miglioramenti esplosivi del rango per i termini principali competitivi.
Protezione della sindacazione: I principali editori spesso distribuiscono i loro contenuti a enormi reti di notizie. Se un sito più piccolo pubblica un'indagine originale, e un enorme sito lo distribuisce, l'enorme sito supererà quasi sempre il creatore originale a causa della pura autorità del dominio. L'unica difesa tecnica è richiedere al partner di syndication di implementare un tag canonico interdominio che rimandi all'URL di origine originale. Ciò trasferisce l'enorme autorità di dominio del sindacato al creatore originale, tutelare la loro proprietà intellettuale.
4. Implementazione pratica & Migliori pratiche di ingegneria
L'implementazione dei tag canonici richiede una precisione programmatica assoluta. Un singolo errore logico nell'intestazione di un sito Web globale può deindicizzare accidentalmente milioni di pagine.
4.1 Gli URL assoluti sono obbligatori
Non utilizzare mai URL relativi in un tag canonico. Gli URL relativi sono vulnerabili alla manipolazione del percorso di base e agli errori strutturali.
<!-- DANGEROUS / INCORRECT -->
<link rel="canonical" href="/mens-shoes/sneakers/" />

<!-- FLAWLESS / CORRECT -->
<link rel="canonical" href="https://[YOUR_DOMAIN]/mens-shoes/sneakers/" />
4.2 Canonicalizzazione dell'intestazione HTTP per risorse non HTML
Una massiccia supervisione tecnica non riesce a canonicalizzare i file non HTML, come i documenti PDF. Se disponi di una pagina Web che spiega una funzionalità del software e una versione PDF scaricabile dello stesso identico manuale, competeranno nelle SERP. Non puoi inserire un codice HTML<link> tag all'interno di un PDF. È necessario configurare il server (Apache/Nginx) per inviare la direttiva canonica all'interno dell'intestazione della risposta HTTP.
# Nginx Configuration Example: Adding Canonical HTTP Header to PDFs
location ~* \.pdf$ {
    # Assuming the PDF filename matches the HTML page path
    add_header Link "<https://[YOUR_DOMAIN]$uri>; rel="canonical"";
}
Questa tecnica avanzata garantisce che tutti i collegamenti creati direttamente al file PDF vengano trasferiti senza problemi alla pagina di destinazione HTML principale, aumentando radicalmente il suo potere di posizionamento.
4.3 Canonici autoreferenziali come meccanismo difensivo
Ogni singola pagina principale del tuo sito web deve avere un tag canonico che punta esattamente al proprio URL (Autoreferenzialità). Perché? Perché raschiatori dannosi, ladri di contenuti, e i server proxy danneggiati possono raschiare il tuo HTML e ospitarlo su un altro dominio. Se il tuo HTML contiene un file hardcoded, tag canonico assoluto che rimanda al tuo dominio autentico, il raschietto dice inavvertitamente a Google, “Sono un duplicato; dare tutto il potere di classificazione al sito originale.” È la difesa automatizzata definitiva contro il furto di contenuti.
4.4 Convalida della logica canonica con Python
Nelle migrazioni massicce, La logica canonica può fallire. Di seguito è riportato uno script Python aziendale per analizzare una mappa del sito XML, estrarre gli URL, strisciarli, e verifica rigorosamente che il tag canonico corrisponda all'URL esatto elencato nella mappa del sito.
import requests
from bs4 import BeautifulSoup
import xml.etree.ElementTree as ET

def audit_sitemap_canonicals(sitemap_url):
    response = requests.get(sitemap_url)
    root = ET.fromstring(response.content)
    namespace = {'ns': 'http://www.sitemaps.org/schemas/sitemap/0.9'}
    urls = [elem.text for elem in root.findall('.//ns:loc', namespace)]

    errors = 0
    for url in urls[:10]: # Check a sample
        try:
            page = requests.get(url, timeout=5)
            soup = BeautifulSoup(page.text, 'html.parser')
            canonical_tag = soup.find('link', rel='canonical')

            if not canonical_tag:
                errors += 1
                continue

            canonical_href = canonical_tag.get('href')
            if canonical_href != url:
                errors += 1
        except Exception as e:
            pass

    print(f"Audit Complete. Found {errors} fatal canonical errors.")
5. Custodie tecniche avanzate & Idee sbagliate comuni
Errore tecnico fatale: Canonicalizzazione delle serie impaginate.
Uno degli errori più distruttivi commessi dagli sviluppatori junior è l'inserimento di un tag canonico nella pagina 2, pagina 3, e pagina 4 di un archivio di categorie che rimanda alla pagina 1 (/category?page=2 canonicalizzare a/category). Pagina 2 contiene prodotti completamente diversi da Page 1; non sono duplicati. Se canonicalizzi page 2 a pagina 1, Google abbandonerà completamente la pagina 2 dall'indice. Ciò significa che il crawler di ricerca non scoprirà mai i collegamenti ai prodotti profondamente annidati nella pagina 2, rimuovendo efficacemente 80% del tuo catalogo e-commerce dal database di Google. Le pagine impaginate devono avere canonici autoreferenziali.
Idea sbagliata: “Posso utilizzare i tag Canonical per reindirizzare un prodotto fuori produzione alla mia home page.”
La realtà: Si tratta di un grave abuso della direttiva. Un tag canonico deve essere utilizzato solo per contenuti identici o molto simili. Una pagina di prodotto specifica non assomiglia semanticamente a un'enorme home page. Gli algoritmi di Google rileveranno l’estrema discrepanza dei contenuti e ignoreranno permanentemente il tag canonico. Per i prodotti fuori produzione, devi usare a 301 reindirizzamento del server a una pagina di sottocategoria altamente pertinente, o servire a 410 (Andato) codice di stato.
6. Tendenze future nell’era della ricerca generativa
Mentre stiamo passando a un’era dominata da agenti IA e modelli linguistici di grandi dimensioni, il tag canonico si evolverà da un semplice strumento di deduplicazione in un fileOrigine Provenienza Ancora. Poiché i motori generativi sintetizzano informazioni da migliaia di fonti, il monitoraggio della proprietà intellettuale diventa fondamentale. I motori di ricerca penalizzeranno pesantemente i LLM che allucinano i dati senza una citazione adeguata. L'etichetta canonica, combinato con nuove firme di contenuto crittografico, servirà come prova algoritmica di proprietà. Quando un'intelligenza artificiale genera una risposta, farà risalire i concetti semantici all'URL canonico di origine, garantire che il creatore originale riceva crediti di citazione e traffico di riferimento.
📚 Riferimenti autorevoli
- https://sviluppatori.google.com/search/docs/crawling-indexing/consolidate-duplicate-urls
- https://datatracker.ietf.org/doc/html/rfc6596
- https://ahrefs.com/blog/canonical-tags/
- https://nginx.org/en/docs/http/ngx_http_headers_module.html
Autore:waglitou,Si prega di indicare la fonte durante l'inoltro: https://www.wanglitou.com/canonical-tag/