Gemini 的終極武器是與 Google Workspace 的集成. 您可以開啟 Google 文件, 類型 “@雙子座”, 並指示它: “總結上週我從 John Doe 收到的有關第四季度 SEO 策略的電子郵件, 提取行動項目, 並將它們格式化為本文檔中的表格。” 這個層次深, Perplexity 目前無法實現跨應用程式資料檢索. Gemini 充當整個企業無所不在的數位助理, 而 Perplexity 則充當高度專業化的研究終端.
2.3 即時網路爬取能力
雖然兩者都可以上網, Perplexity 的爬蟲針對即時新聞和利基論壇進行了積極優化. Perplexity 經常繞過標準 SEO 攔截器從 Reddit 檢索數據, 學術期刊, 和晦澀難懂的子版塊, 綜合社區共識. 雙子座, 在 Google 更嚴格的公司合規性和索引規則下運營, 可能拒絕解析某些動態內容或總結極具爭議性的即時事件,以避免聲譽受損.
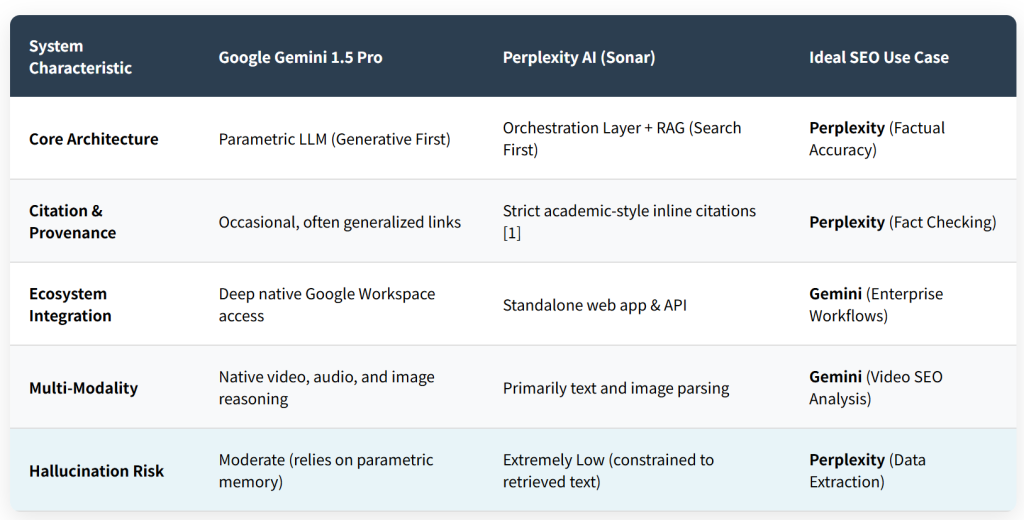
系統特點
Google雙子座 1.5 專業版
困惑人工智慧 (聲納)
理想的 SEO 用例
核心架構
參數法學碩士 (生成第一)
編排層 + 抹布 (首先搜尋)
困惑 (事實準確性)
引文 & 出處
偶然, 通常是廣義的鏈接
嚴格的學術風格內聯引用 [1]
困惑 (事實查核)
生態系整合
深度原生 Google Workspace 存取權限
獨立網路應用程式 & 應用程式介面
雙子座 (企業工作流程)
多模態
原生影片, 聲音的, 和圖像推理
主要是文字和圖像解析
雙子座 (視訊SEO分析)
幻覺風險
緩和 (依賴參數記憶體)
極低 (僅限於檢索到的文本)
困惑 (資料擷取)
3. API利用 & 企業工程工作流程
將這些引擎整合到企業軟體中需要不同的 API 策略.
3.1 雙子座API (谷歌人工智慧工作室)
Gemini API 非常強大, 特別適用於多模式應用. 您可以傳遞原始視訊文件 (最多 1 長達一小時) 透過 API 並請求特定視覺事件的高度詳細的 JSON 時間戳細分.
# Python: Utilizing Gemini API for Multi-Modal Analysis
import google.generativeai as genai
import os

genai.configure(api_key=os.environ["GEMINI_API_KEY"])
model = genai.GenerativeModel('gemini-1.5-pro')

# Assuming a video file has been uploaded to the File API
video_file = genai.get_file(name="files/sample-video-id")

prompt = "Analyze this competitor's promotional video. Extract the core value propositions they mention and output them as a JSON list of strings."

response = model.generate_content([video_file, prompt])
print(response.text)
3.2 困惑API (聲納模型)
困惑提供了它的 “聲納” 透過 API 的模型, 針對基於搜尋的文本生成進行了大量優化. 這對於建立需要保證事實準確性和來源 URL 的自動化研究代理程式的 SEO 來說是理想的選擇.
# Python: Utilizing Perplexity API for Grounded Research
import requests
import json

url = "https://api.perplexity.ai/chat/completions"

payload = {
    "model": "llama-3-sonar-large-32k-online", # Grounded model
    "messages": [
        {"role": "system", "content": "You are a technical SEO researcher."},
        {"role": "user", "content": "What are the latest known Google algorithm updates from the past 30 days? Cite your sources."}
    ],
    "return_citations": True
}
headers = {
    "Authorization": "Bearer YOUR_PERPLEXITY_API_KEY",
    "Content-Type": "application/json"
}

response = requests.request("POST", url, headers=headers, json=payload)
data = response.json()
print("Answer:", data['choices'][0]['message']['content'])
print("Citations:", data.get('citations', []))