定義: 什麼是頁面質量 (質子Q)?
頁面品質 (質子Q) 是整體的, 搜尋引擎利用多維評估指標來確定搜尋引擎的有效性, 安全地, 而特定網頁全面滿足其明確陳述或隱含理解的目的.
它是超越簡單關鍵字相關性的演算法評估的基石, 深入研究結構完整性, 使用者體驗, 內容深度, 和數位資產的聲譽訊號.
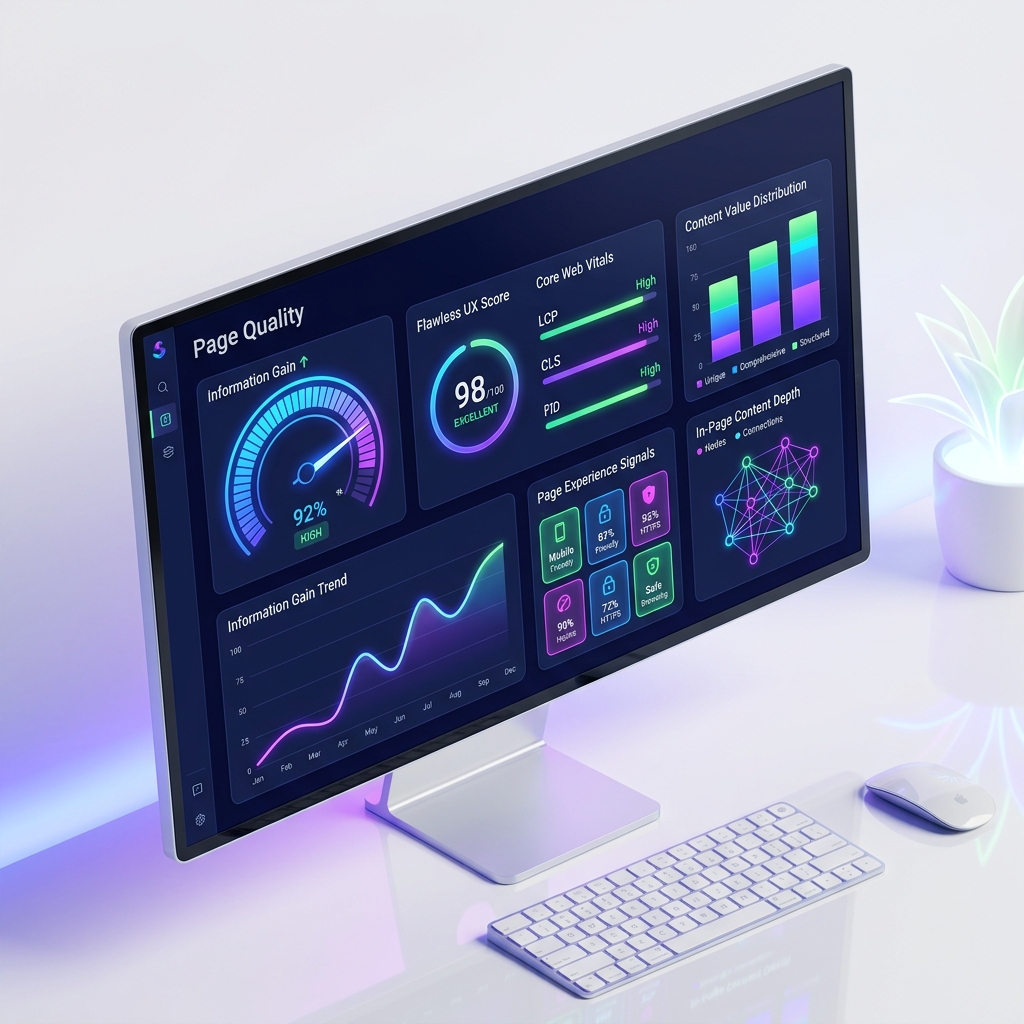
在 Google 的搜尋品質評估器框架內, PQ 按照從「最低」到「最低」的粒度進行了精心分級’ 至“最高”. 達到「最高」的頁面’ 評級不能僅回答查詢; 它必須提供壓倒性的優越性, 以大量資訊增益為特徵的無摩擦體驗, 無可挑剔的 E-E-A-T 訊號, 完美的技術交付 (例如不到 200 毫秒的第一個位元組時間), 並且絕對不存在欺騙性或破壞性的設計模式. 反過來, 表現出惡意意圖的頁面, 欺騙性的貨幣化策略, 或刮傷, 自動化內容立即被譴責為“最低”’ 層, 有效地抵消了他們在競爭性 SERP 中排名的能力.
1. 歷史沿革 & 產業背景
頁面品質指標的歷史演變是搜尋引擎工程師和黑帽網站管理員之間持續戰爭的引人入勝的編年史. 2000年代初, 搜尋演算法從根本上來說是幼稚的, 幾乎完全依賴資訊檢索 (和) TF-IDF 等指標 (詞頻-逆文檔頻率) 和簡單的 PageRank 演算法. 在這個時代, 一個頁面的 “品質” 本質上是由關鍵字出現的次數以及與其連結的域的數量來定義的. 這種結構性缺陷催生了內容農場——大量的網站網路產生了數以百萬計的淺層內容。, 300-專為捕捉長尾搜尋流量而設計的文字文章.
隨著紀念性的「熊貓」的出現,轉捩點到來了’ 2月更新 2011. Panda 對內容農場來說是一場災難性事件; 它引入了經過人類品質評估訓練的機器學習分類器,以透過演算法識別和懲罰「薄內容」。’ 首次, 該演算法可以評估深度, 獨創性, 以及文本本身的語法正確性. 這是現代頁面品質框架的起源.
在隨後的十年裡, PQ 演算法經歷了指數級細化. ‘幻影’’ 更新 (品質更新) 的 2015 開始定位具有激進廣告投放和糟糕使用者體驗的頁面. 引入 Core Web Vitals 2021 實體整合的伺服器回應時間, 視覺穩定性 (累積佈局偏移), 和互動性 (第一個輸入延遲) 直接進入PQ評分矩陣. 今天, 由先進的神經網路架構驅動, PQ 評估是即時的, 多方面的分析,不僅根據內容來判斷頁面, 但關於它如何運作, 誰寫的, 以及更廣泛的互聯網如何看待該域名的聲譽.
2. 核心機制 & 原則
頁面品質評估的基本機制透過不同資料點的複雜聚合來運行, 將語意分析與使用者行為指標和技術性能數據結合. 評估圍繞幾個剛性支柱進行:
2.1 頁面用途評估
在分析任何內容之前, 該演算法嘗試推斷頁面的主要用途. 是為了分享資訊嗎, 銷售產品, 招待, 或提供一個工具? 只有當頁面的目的從根本上來說是有幫助且良性的時,該頁面才有資格獲得高 PQ 評級. 如果演算法分類器偵測到該頁面的真正目的是欺騙用戶 (例如, 偽裝成銀行入口網站的網路釣魚網站), 散佈惡意軟體, 或強制下載不需要的軟體, 該頁面立即被分配最低的 PQ 評級, 繞過所有其他評估.
2.2 主要內容 (MC) 深度和原創性
PQ的核心在於主要內容. 現代演算法利用複雜的自然語言處理 (自然語言處理) 測量 “資訊增益。” 如果一篇文章只是重複維基百科或頂級競爭對手網站上已經存在的事實, 其資訊增益得分接近零. 高品質的 MC 需要大量時間的證明, 努力, 原創研究, 專有數據, 或獨特的分析視角. 演算法主動懲罰 “大規模內容濫用,” 其中以程式設計方式產生數千個頁面,模板略有不同,但唯一值為零.
2.3 補充內容 (SC) 和廣告影響力
PQ評估頁面的整個生態系統. 補充內容是指導航菜單, 相關文章小工具, 和側邊欄. 高 PQ 頁面具有 SC 功能,可積極增強使用者旅程. 反過來, 該演算法嚴厲懲罰廣告模式惡意幹擾 MC 的頁面. 侵入式插頁式廣告, 模糊文字的彈出視窗, 自動播放有聲影片廣告, 專為增加廣告展示次數而設計的分頁方案是災難性 PQ 降級的主要原因.
2.4 網站和創作者的聲譽
PQ 不是在真空中評估的; 它深受外部聲譽訊號的影響. 該演算法在網路上搜尋獨立評論, 維基百科提到, 商業改善局評級, 以及論壇上的討論,以確定實際用戶如何看待品牌. 如果一個網站擁有精美的內容,但大量糟糕的客戶評論聲稱存在欺詐或糟糕的服務, 該演算法限制了網站可以達到的最大可能的 PQ 評級.
3. SEO策略價值 & 深遠影響
優先考慮頁面品質對 SEO 的策略影響是深遠的,並且是針對 Google 核心演算法更新波動性的終極防禦策略. 沉迷於設計高 PQ 的網站不僅僅是在追逐演算法漏洞; 他們正在使自己的商業模式與搜尋引擎的基本指令保持一致: 為使用者提供最佳答案.
演算法免疫性: 高 PQ 最顯著的影響是演算法彈性. 當 Google 推出廣泛核心更新時, 嚴重依賴操縱性連結建立或內容貧乏的網站通常會遭受毀滅性的流量損失. 相比之下, 具有合理高 PQ 指標的站點很少受到影響; 實際上, 由於低品質的競爭對手被從 SERP 中清除,他們經常會遇到流量激增的情況.
抓取預算優化: 搜尋引擎具有高度資源意識. Googlebot 根據歷史網頁品質動態分配抓取預算. 如果某個網域持續發布低 PQ 頁面, Googlebot將倍增其抓取頻率, 這意味著新內容可能需要幾週的時間才能被編入索引. 反過來, 具有發布原始記錄的域名, 高 PQ 含量得益於近乎即時的索引, 讓他們主導新興搜尋趨勢.
SERP 功能主導: 高 PQ 是確保高可見度 SERP 功能(例如精選片段)的絕對先決條件, 知識面板, 並收錄在 Google Discover Feed 中. 這些功能驅動大量, 高轉換流量, 但Google的演算法被編程為僅從通過最嚴格的PQ閾值的頁面中提取數據,以防止直接在搜尋結果頁面上顯示不準確或低品質的信息.
4. 實際實施 & 工程最佳實踐
實現高品質頁面架構需要多學科方法, 融合精英內容創作, 完美的技術搜尋引擎優化, 和嚴格的使用者體驗設計. 下面是非常具體的, 可行的實施:
4.1 透過 UX/UI 工程消除認知摩擦
高 PQ 要求使用者的查詢和答案之間零摩擦. 實施積極進取 “首屏” 最佳化. 確保用戶搜尋意圖的核心答案無需滾動即可立即可見. 利用伺服器端渲染 (固態繼電器) 框架透過 CDN 與積極的邊緣快取相結合,以確保主要內容在用戶螢幕上繪製 1.5 秒. 優化累積佈局偏移 (CLS) 透過嚴格定義絕對為零width 和height 所有動態載入的 DOM 元素的屬性, 確保使用者閱讀時文字不會跳轉.
4.2 產量高 “資訊增益” 內容資產
不要指示作者 “寫 2000 關於 SEO 的詞。” 反而, 強制納入專有數據. 如果您正在編寫有關伺服器效能的指南, 不要只定義 TTFB; 嵌入來自真實伺服器壓力測試的實際 Grafana 儀表板螢幕截圖. 包括自訂編碼的互動式計算器, 使用 HTML 表格的高度詳細的比較矩陣, 和可下載的 JSON 設定文件. 這個專有的 “乾貨” 內容從數學上將您的頁面與數千個通用頁面區分開來, 人工智慧產生的重新哈希主導網絡.
4.3 正面的內容修剪和整合
PQ 在域層級進行評估. 擁有數千個過時的, 薄的, 或低流量頁面充當巨大的錨點,拉低整個網站的平均 PQ 分數. 實施無情的內容修剪協議. 使用Python腳本利用Google Search Console API和Google Analytics API來識別過去獲得零自然點擊的頁面 12 月. 要么全面重寫這些頁面以進行深度分析, 使用合併它們 301 重新導向至高度權威的大師指南, 或果斷刪除它們返回 410 HTTP 狀態碼消失.
# Python Pseudo-code for identifying Low PQ pages based on GSC data
import pandas as pd
from googleapiclient.discovery import build

def identify_low_pq_candidates(gsc_data_csv):
    df = pd.read_csv(gsc_data_csv)
    # Filter pages with high impressions but abysmal CTR and zero clicks (classic thin content signals)
    low_pq_pages = df[(df['Impressions'] > 1000) & (df['Clicks'] == 0) & (df['CTR'] < 0.001)]

    print(f"Found {len(low_pq_pages)} potential Low PQ pages dragging down domain trust.")
    for url in low_pq_pages['Landing Page']:
        print(f"Action Required (Rewrite, 301, or 410): {url}")
5. 先進技術邊緣案例 & 常見的誤解
嚴重的誤解 1: “字數等於頁面質量. 一篇 5,000 字的文章自動獲得高 PQ。”
現實: 這是一個危險的謬論. 搜尋演算法使用先進的 NLP 來衡量資訊密度, 不計字數. 如果一篇 5000 字的文章充滿了重複的廢話, 一般陳述, 和零可操作數據, 它的資訊密度是災難性的. 一個簡潔的, 格式精美的 800 字文章,具有獨特的特色, 專有數據視覺化, 互動式計算器, 專家分析的排名將遠遠超過 5,000 字的文字牆. 人為填充內容很容易被 BERT 等演算法檢測到,並導致快速降級.
嚴重的誤解 2: “使用者產生的內容 (教資會) 像是評論和論壇帖子會降低頁面品質。”
現實: UGC其實是一把雙面刃. 雖然連結到製藥網站的未經審核的垃圾評論絕對會破壞您的 PQ 分數, 精心策劃, 積極的, 專家級的 UGC 顯著增強了它. 當演算法處於活動狀態時, 評論區進行有意義的辯論, 它表明該頁面是一個充滿活力的社區中心. 關鍵是嚴格把關. 實施嚴格的驗證碼, 利用機器學習垃圾郵件過濾器, 積極刪除低品質的 UGC,確保社區互動成為 PQ 的巨大倍增器,而不是負擔.
6. 生成搜尋時代的未來趨勢
隨著我們深入進入生成搜尋時代, 頁面品質的定義正在經歷根本性的範式轉變. 傳統搜尋引擎評估文檔; 下一代人工智慧系統評估 “實體” 和 “知識節點。” 在人工智慧可以立即合成任何查詢的通用 2000 字答案的世界中, 通用資訊內容的價值實際上下降到零.
High PQ 的未來在於 “無法人工智慧” 內容. 最高品質評級將專門保留給具有人工智慧當前無法幻覺或合成的元素的頁面. 這包括高清原創視頻新聞, 即時數據饋送, 具有可驗證的照片證據的實體產品測試, 和高度細緻入微的, 有爭議的, 或前衛的人類觀點. 另外, 技術 PQ 需要與 LLM 消費協議無縫集成. 使用高度特定的模式標記建立高品質資料並公開用於 AI 攝取的乾淨 API 的網站將成為新生成搜尋生態系統的基本支柱.
📚 權威參考文獻
- https://Developers.google.com/search/docs/fundamentals/creating-helpful-content
- https://web.dev/articles/vitals
- https://www.searchenginejournal.com/google-core-web-vitals-ranking-signals/387142/
- https://ai.google/research/pubs/pub456
作者:wanglitou,轉發時請註明出處: https://www.wanglitou.com/page-quality-pq/