定義: 什麼是TDK?
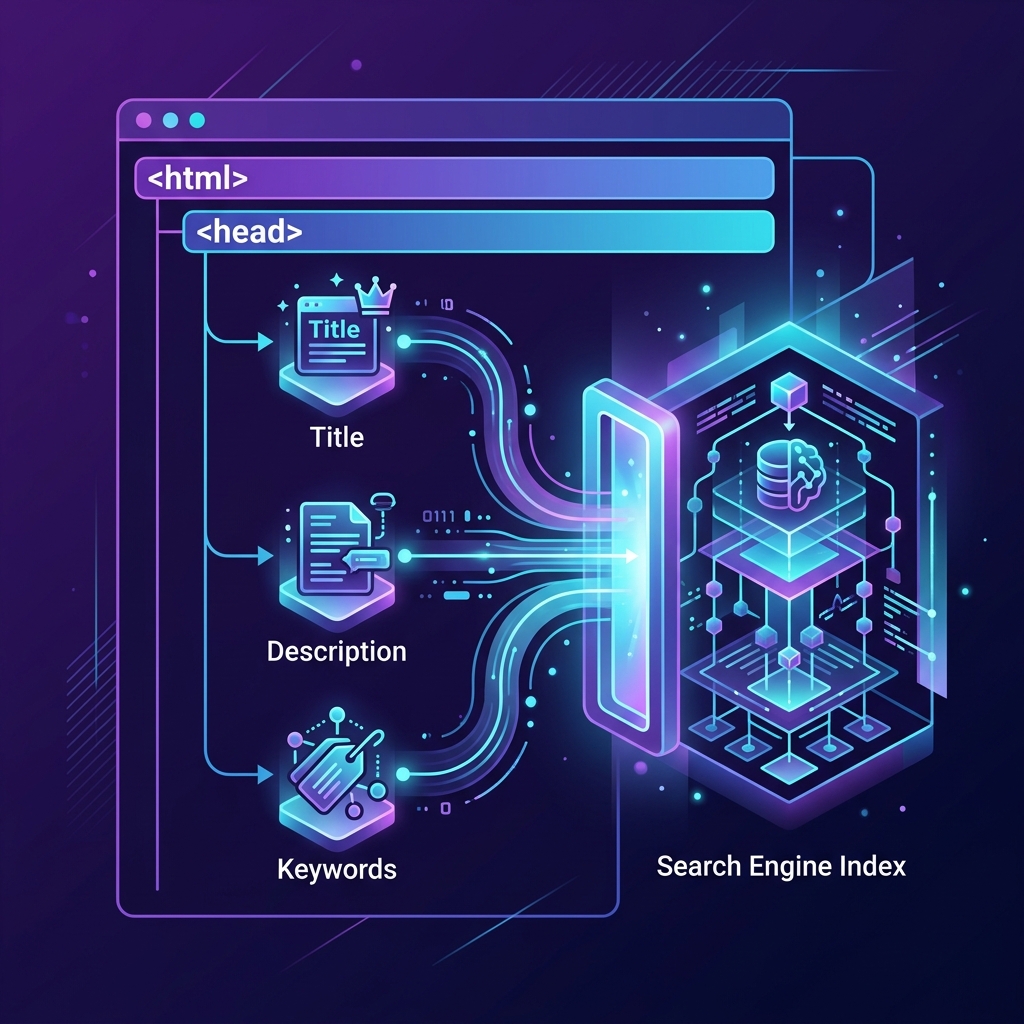
TDK (標題, 描述, 關鍵字) 代表嵌入在 HTML 中的基本 HTML 元標記的三元組 “ 網頁文檔的元素.
歷史上充當網站管理員意圖和搜尋引擎爬蟲索引之間的主要語義橋樑, TDK 框架規定了精確的術語, 專題分類, 以及在搜尋引擎結果頁面上顯示的面向使用者的副本 (搜尋結果頁面). 雖然「關鍵字’ 由於系統濫用,該標籤已被主要引擎普遍棄用作為排名訊號, ‘標題’’ 標籤仍然是頁面排名中權重最高的因素之一, 和“元描述”’ 充當控制自然點擊率的關鍵心理催化劑 (點擊率).
僅將 TDK 視為“標籤”’ 是一個基本的架構錯誤. 在現代企業SEO中, 標題和描述是工程資料點,必須同時滿足 NLP 模型的嚴格實體擷取演算法 (像伯特一樣) 同時部署先進的文案啟發法,以在典型 SERP 用戶的 0.5 秒視覺掃描模式內捕捉人類注意力.
1. 歷史沿革 & 產業背景
TDK的歷史是搜尋引擎技術整個演進的縮影. 1990年代中後期, 搜尋演算法缺乏語意理解. 他們使用精確匹配的布林邏輯進行操作. 最後, 這<meta name="keywords"> 標籤是無可爭議的 SEO 之王. 網站管理員會注入數百個逗號分隔的, 隱藏的關鍵字(通常與頁面內容完全無關)以捕獲大量不同的流量. 這個「關鍵字堆砌」的時代’ 創造了一個充滿無關內容的互聯網, 低品質結果.
隨著 Google PageRank 演算法的崛起,範式發生了根本性的轉變, 引入頁外連結資產作為主要信任訊號, 將元關鍵字降級為次要角色. 九月 2009, 谷歌正式公佈了SEO界長期以來的懷疑: 他們的網路搜尋排名演算法完全忽略了元關鍵字標籤.
然而, 標題標籤 (<title>) 和元描述 (<meta name="description">) 保留了巨大的力量. 標題標籤仍然是頁面上用於傳達主題相關性的最強單段文本. 元描述從排名因素轉變為廣告文案機制. 在現代, 遵循 2019 BERT更新, 如果演算法確定硬編碼的 TDK 與使用者的特定搜尋意圖不完全一致,Google 就會開始動態重寫 SERP 上的標題和描述, 有效地從網站管理員手中奪取絕對控制權並將其置於神經網路手中.
2. 核心機制 & 原則
TDK 處理背後的技術機制涉及解析 DOM, 提取字串文字, 並將它們映射到查詢意圖向量. 此過程受到嚴格的字元限制, 像素寬度, 和語意相關性評分.
2.1 標題標籤機制 (主題相關性 & 實體注入)
Googlebot 不會將標題標籤讀取為連續的句子; 它被解析為不同的實體和 N 元語法. 該演算法對文字應用衰減權重, 意思是放置在標題標籤絕對開頭的單字 (前裝式) 被分配的相關權重明顯高於最後的單字. 另外, Google 評估渲染標題的像素寬度 (通常上限約為 600 像素或大致 55-60 人物). 超過此限制會導致截斷, 這不僅會降低用戶體驗,而且有時會掩蓋頁面嘗試排名的核心實體.
2.2 元描述機制 (點擊率催化劑)
雖然Google明確表示元描述不會直接影響排名, 他們透過點擊率的行為訊號間接影響演算法 (點擊率). 如果頁面排名靠前 4 但擁有非常引人注目的元描述,吸引了大量的點擊 (高預期點擊率. 實際點擊率增量), 該演算法可能會提升頁面的位置 2 或者 1, 推斷這是一個更好的結果. 此機制要求描述大致如下 960 像素 (155-160 人物) 最好包含確切的搜尋查詢, 搜尋引擎將以粗體文字視覺突出顯示, 顯著吸引使用者的眼球.
2.3 演算法重寫 (標題標籤覆蓋)
八月 2021, 谷歌對其在搜尋結果中生成網頁標題的方式進行了大規模更新. 而不是盲目相信<title> 標籤, Google 現在利用複雜的 HTML 解析機制根據視覺突出度動態產生標題. 如果您的標題標籤被認為不相關, 太長, 或者 “填充的,” 該演算法將忽略它並從 H1 標籤中提取文本, 突出的H2, 甚至是從外部網站指向頁面的錨文本. 此機制可確保 SERP 保持乾淨, 迫使 SEO 使其內部標題架構與元標籤完美對齊.
3. SEO策略價值 & 深遠影響
TDK 完美優化的策略影響不容小覷. 這是技術 SEO 中絕對投資報酬率最高的活動. 你可以花 $50,000 取得高權威反向連結並優化伺服器速度, 但如果您的標題標籤是通用的並且您的元描述丟失, 用戶根本不會點擊 SERP 上的鏈接. TDK 代表搜尋引擎和您的網站之間轉換漏斗的最後一毫米.
企業級 A/B 測試 TDK: 在企業層面 (例如, 電子商務網站 5 百萬個 SKU), TDK 以程式設計方式管理. 一個 1% 整個投資組合的點擊率增加 5 由於動態優化的標題標籤模板,百萬頁可以導致每月數十萬個額外的自然會話, 直接轉化為數百萬美元的在地化收入. 戰略 SEO 不將 TDK 視為靜態文本, 但作為連續的動態變量, 多變量測試矩陣.
4. 實際實施 & 工程最佳實踐
正確實作 TDK 需要超越基本的 CMS 外掛程式並利用程式碼級工程來確保程式設計完美, 尤其是在大規模 JavaScript 渲染的應用程式上.
4.1 React/Next.js 中的程式設計生成
在現代單頁應用程式中 (SPA), TDK是動態注入的. 然而, 如果此註入發生在客戶端, 如果搜尋引擎的 JavaScript 執行預算耗盡,則可能無法呈現它. TDK 必須使用伺服器端渲染來實現 (固態繼電器).
// Example: Server-Side TDK Injection
import Head from 'next/head';

export default function ProductPage({ productData }) {
  // Construct a mathematically precise Title
  const metaTitle = `${productData.category} ${productData.brand} ${productData.model} - Buy Online | [YOUR_DOMAIN]`;

  // Construct a compelling description
  const metaDesc = `Looking for the best ${productData.category}? Buy the ${productData.brand} ${productData.model} for only $${productData.price}. In stock with free 2-day shipping.`;

  return (
    <>
      <Head>
        <title>{metaTitle}</title>
        <meta name="description" content={metaDesc} />
      </Head>
      <main>
        <h1>{productData.brand} {productData.model}</h1>
      </main>
    </>
  );
}
4.2 用於 TDK 提取的 Python 審核腳本
企業 SEO 需要對海量 URL 集的 TDK 進行持續審核. 依賴人工檢查是不可能的. 以下是一個強大的 Python 腳本,利用 BeautifulSoup 和並發 future 積極審核數千個 URL 上的 TDK 實現, 標記那些違反長度限制的內容.
import requests
from bs4 import BeautifulSoup
import concurrent.futures
import csv

URLS_TO_AUDIT = [
    "https://[YOUR_DOMAIN]/page1",
    "https://[YOUR_DOMAIN]/page2",
]

def audit_url(url):
    try:
        response = requests.get(url, timeout=5)
        soup = BeautifulSoup(response.text, 'html.parser')

        title_tag = soup.find('title')
        title = title_tag.text.strip() if title_tag else "MISSING"
        title_len = len(title)

        desc_tag = soup.find('meta', attrs={'name': 'description'})
        description = desc_tag['content'].strip() if desc_tag and 'content' in desc_tag.attrs else "MISSING"
        desc_len = len(description)

        status = "PASS"
        if title == "MISSING" or title_len > 60 or description == "MISSING" or desc_len > 160:
            status = "FAIL"

        return {"URL": url, "Title": title, "Title_Length": title_len,
                "Description": description, "Desc_Length": desc_len, "Status": status}
    except Exception as e:
        return {"URL": url, "Status": f"ERROR: {str(e)}"}

with concurrent.futures.ThreadPoolExecutor(max_workers=20) as executor:
    results = list(executor.map(audit_url, URLS_TO_AUDIT))

print(f"Audit Complete. Processed {len(results)} URLs.")
5. 先進技術邊緣案例 & 常見的誤解
極端邊緣情況: 這 “附加品牌名稱” 重複問題.
許多 CMS 平台會自動將網站名稱附加到每個標題標籤的末尾. 如果 SEO 手動將網站名稱輸入到標題輸入中, 將顯示渲染的 HTML “關鍵字目標 – 網站名稱 – 網站名稱”. 谷歌的標題重寫演算法將這個重複的樣板字串視為嚴重的垃圾郵件,並將積極重寫整個標題, 經常從頁面中選擇完全次優的 H2. 審核原始碼以確保自動附件不與手動輸入衝突至關重要.
誤解: “我必須為所有人編寫獨特的元描述 1 我的產品頁面有數百萬個。”
現實: 手動書寫 1 百萬個描述是對組織資源的極大浪費. 谷歌明確允許, 並期望, 大型電子商務資料庫元描述的程式設計生成. 只要模板動態注入唯一的, 高度具體的產品變數 (例如, “購買 [顏色] [品牌] [模型] 和 [貯存] 為了 [價格].”), 它完全符合品質準則,不會引發重複內容處罰.
6. 生成搜尋時代的未來趨勢
在生成搜尋時代, 傳統的TDK優化正在演變為語意實體對齊. 當使用者查詢AI時, AI 不會掃描列表 10 藍色連結; 它直接合成答案. 然而, 這些法學碩士仍然從網路索引中提取引文數據. 將來, 標題標籤必須起到嚴格的作用, 明確的實體識別符. 而不是點擊誘餌 (“你不會相信這個 SEO 技術技巧”), 標題的結構必須適合機器理解 (“技術 SEO 實施指南: 伺服器端渲染”).
另外, 我們預計新的出現, 專門設計用於為法學碩士提供數學上精確的人工智慧特定元標籤, 頁面核心論文的預先計算向量嵌入, 允許搜尋引擎在檢索增強一代期間繞過昂貴的計算週期 (抹布) 過程. TDK 儘早採用嚴格的語意結構是面向未來的終極策略.
📚 權威參考文獻
- https://Developers.google.com/search/docs/appearance/title-link
- https://Developers.google.com/search/docs/appearance/snippet
- https://moz.com/learn/seo/title-tag
- https://Reactjs.org/docs/dom-elements.html
作者:wanglitou,轉發時請註明出處: https://www.wanglitou.com/tdk-title-description-keywords/